Studie přírody odhaluje: Počítače generovaly falešné stopy v evoluční historii Corony
Kde končí biologické důkazy a kde začíná falešně vytvořená, počítačem generovaná historie SARS-CoV-2?
Studie publikovaná v únoru 2026 v časopise Nature Methods potvrzuje, že „většina genomů SARS-CoV-2 získaných během pandemie“ byla vytvořena pomocí metody rekonstrukce, která může vést k „systematickým chybám v genomech“.
Tyto chyby nejenže poškodily jednotlivé soubory genomových dat.
Podle autorů následovaly vlny variant COVIDu „vlny systematických chyb“, které měly „významný vliv na odvozený fylogenetický strom“ – tedy na počítačem podporovanou rekonstrukci použitou k popisu údajného vývoje SARS-CoV-2 a genetického vztahu mezi různými vzorky.
Studie odhaluje, jak k tomu došlo: Některé softwarové programy jednoduše vyplnily místa, kde sekvenování neposkytovalo data, písmeny zkopírovanými z referenční sekvence SARS-CoV-2.
Protože tento odkaz je již považován za předpokládaného předka, mohlo by se tvrzení „nevíme, co zde bylo napsáno“ stát „sekvence předka byla napsána zde“.
Tato písmena, nelegálně vložená počítačem, by se pak mohla stát falešnými indikacemi, že SARS-CoV-2 zmutoval zpět ke svému údajnému předkovi.
Vědci nakonec získali přístup k archivovaným datům sekvenování z milionů pandemických genomů a zrekonstruovali je.
V důsledku toho zmizela řada údajných evolučních událostí, téměř 30 000 vzorků změnilo svou linii a následná analýza odhalila o 1 400 méně údajných samostatných zavlečení SARS-CoV-2 do Spojených států.
Údajná biologická minulost se nezměnila.
Počítačem generovaný genetický záznam použitý k rekonstrukci této minulosti je však pravdivý.
To odhaluje problém, který je zásadnější než špatný software.
Pokud by změna ve způsobu, jakým počítače rekonstruovaly genomy SARS-CoV-2, mohla změnit mutace, přiřazení linií a rekonstruovanou historii přenosu, pak by se nejednalo pouze o pozorování toho, co virus dělá.
Jednalo se o závěry vyvozené z počítačově podporovaných rekonstrukcí sekvenčních dat.
A samotné rekonstrukce by mohly být chybné.
Studie proto nastoluje otázku, která dalece přesahuje konkrétní chyby, které Hunt a kol. opravili:
Kde končí biologické důkazy a kde začíná počítačem generovaná historie SARS-CoV-2?
„Většina genomů SARS-CoV-2“
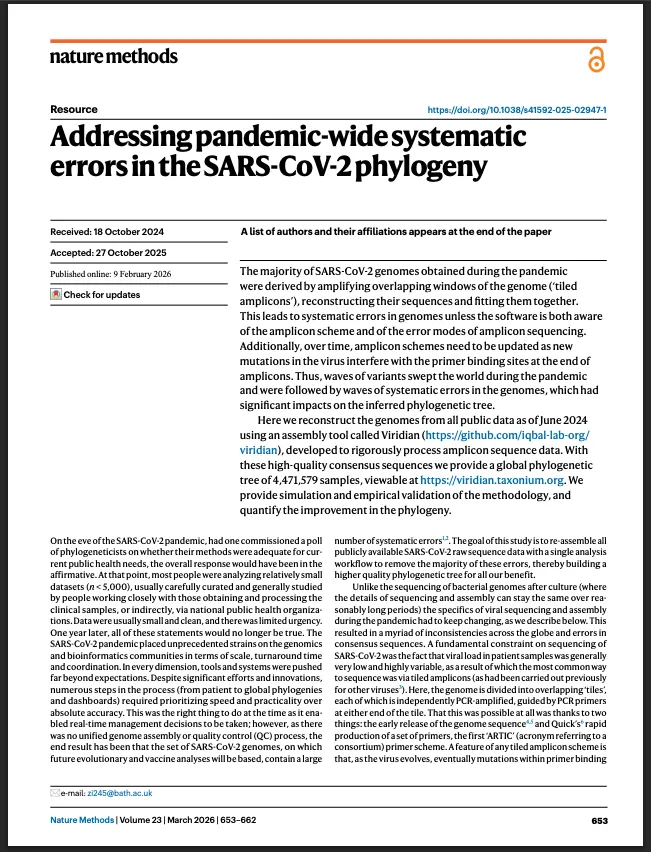
Hunt a kol. popsali rozsah problému neobvykle jasně ve shrnutí své práce:
„Většina genomů SARS-CoV-2 získaných během pandemie byla určena amplifikací překrývajících se segmentů genomu („dlaždicové amplikony“), rekonstrukcí jejich sekvencí a jejich spojením. To vede k systematickým chybám v genomech, pokud software nezohledňuje buď schéma amplikonu, nebo typy chyb, ke kterým dochází během sekvenování amplikonů. Schémata amplikonů musí být navíc v průběhu času aktualizována, protože nové mutace ve viru ovlivňují vazebná místa primerů na koncích amplikonů. Během pandemie se tak po celém světě přehnaly vlny variant, následované vlnami systematických chyb v genomech, což mělo významný dopad na odvozený fylogenetický strom.“
Tato část stanoví čtyři fakta.
- Většina genomů SARS-CoV-2 z pandemie byla rekonstruována z amplifikovaných, překrývajících se fragmentů.
- Tento proces může vést k „systematickým chybám v genomech“.
- Autoři tvrdí, že vlny variant byly následovány „vlnami systematických chyb“.
- A tyto chyby měly „významný dopad“ na údajný evoluční strom.
To je důležité, protože strom není jen ilustrací.
Genetické rozdíly mezi rekonstruovanými genomy se používají k odvození (předpokládání), které vzorky spolu souvisejí, kde došlo k mutacím, které vzorky patří do kterých linií a jak tyto linie údajně pocházejí z dřívějších.
No a co?
Systematické chyby byly v důkazech přítomny již předtím, než byly transformovány do evoluční historie.
Základní otázka je proto nevyhnutelná:
Pokud většina genomů SARS-CoV-2 prošla procesem rekonstrukce, při kterém se mohou vyskytnout systematické chyby, a tyto chyby významně změnily odvozený fylogenetický strom, do jaké míry údajná evoluční historie COVIDu odráží skutečnou biologickou realitu a do jaké míry odráží to, co chybně vytvořil software rekonstrukčního systému?
Sekvenční data neposkytla žádnou odpověď.
Hunt a kol. šli nad rámec hotových genomů GenBank a zkoumali archivované sekvenční čtení, které bylo použito k jejich vytvoření.
Ve své doplňkové analýze Hunt a kol. konkrétně hledali části genomů GenBank, kde archivované sekvenční čtení neposkytovalo pokrytí.
To znamená, že neexistovaly žádné sekvenční čtení, které by ukázalo, která genetická písmena jsou skutečně přítomna.
Nicméně, kompletní genom GenBank tvrdil, že určitá písmena odpovídají referenční sekvenci.
Vědci uvedli, že „z výsledků přečtení nevyplývá žádný důkaz, který by podporoval zařazení do kategorií A, C, G nebo T“.
Jinými slovy, podkladová sekvenční data naznačovala:
- Nevíme, která genetická písmena byla zapojena.
Hotový genom však uváděl:
- Tato specifická genetická písmena zde byla přítomna.
Bez ohledu na to, kolik důvěry člověk obecně vkládá do sekvenování genomu, tyto specifické mezery představují jednodušší problém:
Sekvenční data neposkytla odpověď, ale hotový genom ji stále obsahoval.
No a co?
Pokud sekvenční čtení nemohlo prokázat, zda pozice obsahuje A, C, G nebo T, nemohlo se v dané pozici určit, zda je údajný virus stejný nebo odlišný od jiného.
Právě tyto genetické podobnosti a rozdíly se však v následných evolučních analýzách používají k rekonstrukci vztahů a změn.
Pokud podkladová data neprokázala, co tam bylo, jak se mohla na jejich místě objevit jasná genetická sekvence a následně legitimně sloužit jako důkaz toho, co SARS-CoV-2 údajně způsobil?
Počítač poskytl informace o předpokládaném předkovi.
Hunt a kol. ukazují, jak k tomu došlo.
Některé programy pro konstrukci genomu vynutily doplnění chybějících dat segmenty referenční sekvence SARS-CoV-2.
Autoři popisují tento přístup jako „falešný předpoklad“: Pokud oblast neobsahovala žádné čtení, software by stále mohl předpokládat, že chybějící sekvence odpovídá referenci.
A reference v evoluční analýze představovala předpokládanou prekurzorovou sekvenci SARS-CoV-2.
Proces tedy probíhal následovně:
Žádné důkazy o sekvenování
→ Software vloží předpokládanou prekurzorovou sekvenci
→ Hotový genom obsahuje jednoznačné prekurzorové markery
→ Následná analýza zachovává tyto symboly jako součást genomu.
Vzorek neposkytl žádné důkazy o těchto písmenech v těchto pozicích.
Počítač je vložil přesně proto, že neexistovaly žádné další indicie.
Hunt a kol. tvrdí, že části referenční sekvence byly použity k vyplnění mezer ve „velkém počtu sekvencí“ a že tento efekt sám o sobě je „významnou příčinou zpětného vývoje ve fylogenetickém stromu“.
No a co?
Vědci se snažili odvodit, jak se vzorky lišily od svého předpokládaného předka, zatímco software pro konstrukci genomu jednoduše vložil tohoto předpokládaného předka do vzorku všude, kde neexistovaly žádné důkazy.
To obrací normální směr argumentu.
Místo toho, aby vzorek nezávisle a přímo prokázal, že se shoduje s předpokládaným předkem, poskytl shodu samotný předpokládaný předek.
Jak lze tuto počítačem generovanou podobnost legitimně považovat za důkaz původu nebo evoluce?
Nedostatek důkazů vedl k falešné evoluční teorii.
Důsledky se odrazily v evolučním stromu.
Mechanismus je jednoduchý.
Předpokládaný předek:
A
Údajný potomek:
G
Pozdější vzorek bez důkazů o sekvenování:
?
Odkaz ze softwaru:
A
Kompletní genomy nyní vykazují následující:
A → G → A
Evoluční analýza naznačuje, že SARS-CoV-2 mutoval od svého předpokládaného předka a poté znovu mutoval.
Ale vzorek nikdy nepřinesl konečné A.
Počítač to tam vložil.
Hunt a kol. identifikují velký počet zvratů jako důležitý indikátor artefaktů ve stromech vývoje pandemie.
No a co?
Údajná událost v biologické historii SARS-CoV-2 by mohla být založena na informacích, které nikdy nebyly získány z relevantní části vzorku.
Epistemický řetězec nyní vypadal takto:
Nedostatek důkazů → počítačem generovaná sekvence → odvozená mutace → údajný příběh o viru.
Pokud údajná evoluční událost existuje pouze proto, že software původně poskytl genetický stav, který tuto událost vyžadoval, jaké důkazy to pak dokazují, bez ohledu na to, zda údajný virus sám o sobě někdy prošel údajnou evolucí?
Vlny variant vedly k vlnám systematických chyb.
Hunt a kol. popisují problém, který se vyvinul souběžně s údajným virem.
Říká se, že metoda dlaždicových amplikonů závisí na primerech, které působí na specifických genetických místech.
Podle autorů by nové mutace mohly ovlivnit tato vazebná místa primerů, což by si vyžádalo aktualizaci amplifikačních schémat.
Proto její pozoruhodné prohlášení:
„Vlny variant“ byly následovány „vlnami systematických chyb v genomech“.
Profil chyb proto nebyl nutně konstantní po celou dobu pandemie.
Mohlo by se to změnit, stejně jako se změnil údajný virus.
No a co?
Tytéž genetické změny, které se vědci snažili zdokumentovat, by mohly narušit výkon systému použitého k jejich dokumentaci.
To vede k problému epistemické zpětné vazby:
Výzkumníci použili sekvenční systém k identifikaci měnících se variant, přičemž měnící se varianty by mohly následně vést ke změnám systematických chyb v genomech odvozených ze sekvenování.
Pokud by se během vlny variant objevil nový genetický vzorec, jak spolehlivě by mohli následní výzkumníci rozlišit biologickou změnu v SARS-CoV-2 od nové systematické chyby, která vznikla proto, že údajná biologická změna ovlivnila systém použitý k rekonstrukci genomu?
Chyby vstoupily do evolučního stromu.
Hunt a kol. ve své diskusi jasně uvádějí důsledky.
Píšou:
„Důsledky používání více pracovních postupů pro sestavování genomu různé kvality, nekonzistentních kritérií kontroly kvality a nevyhnutelné společné evoluce virových a amplikonových schémat vedly k systematickým chybám v genomech, a tedy i ve fylogenezi.“
Z této věty je jasně patrné, kde se staly chyby.
Do genomů.
A následně:
Do evolučního stromu.
No a co?
Jakmile se do hotového genomu dostane nesprávné genetické písmeno, následná analýza automaticky nerozpozná, že toto písmeno představuje nepřípustný artefakt a nikoli biologickou realitu.
Může se stát dalším datovým bodem, ze kterého lze odvodit – nikoli pozorovat – předky a evoluci a následně je operacionalizovat.
Sami autoři popisují problém jako pokus odlišit „artefakt od biologie“.
Toto je velmi důležité:
Pokud by vědci zkoumající evoluční strom museli určit, zda něco, co se v něm objevuje, představuje „artefakt“ nebo „biologickou realitu“, pak samotný strom nelze jednoduše ztotožnit s pozorovanou biologickou historií.
Rekonstrukce genomů vymazala údajnou evoluci.
Hunt a jeho kolegové opět použili veřejně archivovaná sekvenční data a rekonstruovali miliony údajných genomů SARS-CoV-2 pomocí standardizovaného postupu zvaného Viridian.
Výsledný evoluční strom pak porovnali se stromem založeným na GenBank.
Strom GenBank obsahoval 63 pozic genomu s nejméně 200 předpokládanými reverzemi.
Rodokmen viridiánů obsahoval:
20.
Údajné viry se nevrátily v čase a nezměnily se.
Počítačem generovaná reprezentace se změnila.
A velké množství údajných evolučních událostí zmizelo.
No a co?
To znamená, že ne všechny tyto události lze považovat za nezávisle prokázaná fakta o biologickém působení SARS-CoV-2.
Alespoň některé závisely na tom, jak počítače převedly sekvenční data do hotových genomů.
Pokud je základní biologická minulost stanovena, ale rekonstrukce pozmění předpokládanou evoluční historii – která z nich je uvedena, když vědci říkají: „Virus se dále vyvinul“?
Téměř 30 000 vzorků změnilo svůj původ.
Účinky se rozšířily i na názvy dané údajným virovým liniím.
Hunt a kol. našli 29 475 vzorků, jejichž zařazení do linií Pango-Coronavirus se lišilo v závislosti na tom, zda byl použit genom GenBank nebo rekonstrukce viridiánů.
Samotné vzorky se nezměnily.
Jejich počítačem generovaná genetická reprezentace se však změnila.
A když se toto zastoupení změnilo, změnila se i klasifikace téměř 30 000 vzorků.
No a co?
„Tento vzorek patřil k linii X“ zní jako vnitřní biologický fakt objevený ve vzorku.
V těchto vzorcích však odpověď závisela na tom, která rekonstrukce sekvenčních dat byla přenesena do systému klasifikace linií.
Pokud se může změnit původ vzorku, pokud se změní jeho počítačem rekonstruovaný genom, kde končí biologická identita a kde začíná algoritmická klasifikace?
Rekonstruovaná historie zavlečení COVIDu do USA se změnila.
Výzkumníci z „Nature Methods“ poté zkoumali, zda má rekonstrukce genomů nějaké další důsledky nad rámec evolučního stromu: jejich rekonstrukce toho, jak často byl SARS-CoV-2 pravděpodobně zavlečen do různých zemí.
Analýza provedená Huntem a kol. s využitím původních genomů z GenBank odhalila:
- 15 026 samostatných zavlečení viru SARS-CoV-2 do Spojených států.
Použití genomů, které Hunt a kol. rekonstruovali z archivovaných sekvenačních dat:
- 13 626.
Výzkumníci tak po změně způsobu rekonstrukce analyzovaných sekvenčních dat obdrželi do USA o 1 400 méně odvozených importů.
Hunt a kol. vysvětlují, že chyby v genomu mohly oddělit vzorky, které měly být seskupeny, což vedlo jejich geografickou analýzu k odvození dalších umělých „zavádění“.
Je důležité, aby tým nepřipisoval všech 1 400 případů konkrétně chybě při dokončení reference.
Jejich rekonstruované genomy opravily několik typů chyb.
Epistemický důsledek je však zásadní.
Ani číslo 15 026, ani číslo 13 626 neznamená, že by vědci přímo pozorovali, jak často se SARS-CoV-2 dostával do Spojených států.
Oba údaje jsou trendy odvozenými z genetických vztahů mezi počítačem rekonstruovanými genomy.
Změna genomů mění odvozenou historii o 1400 údajných zavedení.
No a co?
Chyby, ke kterým došlo během konstrukce digitálních genomů, byly tak závažné, že změnily předpovědi modelu stejných výzkumníků o skutečném průběhu pandemie.
Pokud rekonstrukce genetických dat dokáže vymazat 1 400 odvozených záznamů o SARS-CoV-2 ve Spojených státech, kolik dalších tvrzení o tom, kde virus údajně vznikl, kam se dostal a jak se šířil, nezávisí na přímo pozorovaných událostech, ale spíše na konkrétní počítačově podporované rekonstrukci použité k jejich odvození?
Základní problém sahá za hranice COVIDu
Hunt a kol. prezentují Viridian částečně jako řešení pro budoucí epidemie a pandemie.
Zejména doufají, že jejich práce zkrátí čas strávený zkoumáním stromů a snahou „rozlišovat artefakty od biologických jevů“.
Toto znění zdůrazňuje základní problém.
Konečný genetický záznam může obsahovat obojí.
A výzkumníci možná budou muset následně určit, co je co.
To není důležité jen v kontextu SARS-CoV-2, protože moderní genetika běžně pracuje na několika úrovních: Biologický materiál poskytuje měření z měřicích zařízení; software převádí tato měření na genetické nálezy; výpočetní technologie kombinují tato zjištění do sekvencí; algoritmy porovnávají tyto sekvence; a modely z nich odvozují příbuzenské vztahy, předky a evoluční historii.
Hunt a kol. nedokazují, že sekvenování genomu je obecně neplatné.
Dospějí k přesnějšímu závěru.
A jeden, který je epistemicky významný:
Dokončený genom se automaticky neshoduje se základními znalostmi a biologické vysvětlení odvozené z tohoto genomu obsahuje chyby, ke kterým došlo během jeho vzniku.
Toto rozlišení se stává klíčovým, jakmile jazyk tyto úrovně sloučí.
- Rekonstruovaná sekvence se stává „genomem“.
- Rozdíl mezi rekonstruovanými genomy se stává „mutací“.
- Matematicky odvozený vztah se stává „sestupem“.
- Odvozený rodokmen se stává „evoluční historií“.
V jakém bodě tohoto řetězce se z pozorování získaného pomocí přístroje stal závěr získaný počítačem?
A od jakého okamžiku byl tento závěr prezentován, jako by se jednalo o samotnou biologickou událost?
Závěr
Studie publikovaná v časopise „Nature Methods“ ukazuje, že do genomů SARS-CoV-2 se vkradly systematické chyby a významně ovlivnily údajný evoluční strom, který z nich byl vytvořen.
V jednom zdokumentovaném případě chyby software vyplnil oblasti předpokládanou prekurzorovou sekvencí, přestože podkladová sekvenční data neposkytovala žádnou indikaci toho, co se tam skutečně nachází.
Tyto počítačem generované dopisy by se pak mohly stát falešným důkazem o evoluci virů.
Když Hunt a kol. rekonstruovali miliony genomů s využitím archivovaných sekvenčních dat, předpokládané evoluční události zmizely, klasifikace linií se změnila u téměř 30 000 vzorků a jejich rekonstrukce vedla k o 1 400 méně odvozených introdukcí do USA.
Údajná biologická minulost se nezměnila; počítačem generovaný genetický záznam se změnil a s ním se změnila i historie z něj odvozená.
Základní problém tedy nespočívá jen v tom, že některé genomy obsahovaly chyby.
Spíše spočívá ve skutečnosti, že počítačem rekonstruované genomy byly použity jako důkaz mutací, linií, původu, evoluce a historie přenosu, přestože studie ukazuje, že samotná rekonstrukce by mohla vést k falešným biologickým důkazům.
To zbývá ústřední otázka:
Kolik z údajné genetické historie nebo alibi COVID-19 bylo podpořeno podkladovými biologickými důkazy a kolik z toho bylo vygenerováno počítačovými systémy použitými k transformaci těchto důkazů do genomů, evolučních stromů a tvrzení o tom, co SARS-CoV-2 údajně udělal?
Od Jona Fleetwooda